
juni 2026
A Best-of-Breed Chain for AI-Assisted Software Development
Varför det svåra med vibe coding är verifiering, inte generering, och hur Claude Code, GitHub, Vercel, Next.js och Postgres sluter den loop vi bygger Nashua 360-plattformen på
Sammanfattning
En kompetent kodningsagent förändrar mjukvaruutvecklingens ekonomi: att skriva kod, den verksamhet som förr dominerade en utvecklares dag, blir snabbt och nära nog gratis, medan verksamheterna omkring den, att avgöra vad som ska byggas och att förvissa sig om att resultatet är korrekt, inte blir det. Flaskhalsen flyttar från generering till verifiering. Denna artikel hävdar att värdet i en AI-assisterad utvecklingsmiljö inte ligger i modellen som skriver koden utan i kedjan av verktyg omkring den som låter ett team verifiera, i hög takt, det agenten producerar, och som fångar dess misstag innan de når användarna. Det är en teknisk och tydligt ställningstagande redogörelse för den kedja vi på Nashua bygger och driver vår egen produkt, Nashua 360 Enterprise Platform, på, och för varför varje länk är den den är: Claude Code som agent, körd i en loop med resten av kedjan och nåbar från en mobilapp så att en ändring kan påbörjas och ett resultat granskas från en telefon; GitHub som ryggrad, med en skyddad huvudgren, obligatoriska statuskontroller och en pull request som förändringens enhet; Vercel som ger varje pull request sin egen isolerade, körande förhandsdistribution; Next.js som ett typat, konventionellt ramverk vars typkontroll är den första och billigaste grinden och vars renderings- och körtidsmodell agenten navigerar ledigt; och PostgreSQL som varaktigt tillstånd, ändrat genom granskade, återställbara migreringar. Vi går in på de delar praktiker bryr sig om: hur agenten ges sammanhang och hålls ärlig, vad som körs i kontinuerlig integration, vad en förhandsdistribution faktiskt är, hur Next.js renderar och var den körs, och hur man ändrar en live-databas utan att bryta sönder den. Vi hävdar att för AI-assisterat arbete betyder best-of-breed konventionellt, eftersom agenten skriver de verktyg den sett mest av bäst, och vi är uppriktiga om kostnaderna: leverantörsbindning, den disciplin den mänskliga granskningsgrinden kräver, risken med en agent med bred åtkomst, och datats oåterkallelighet. Detta är råd riktade till praktiker, inte ett riktmärke.
Nyckelord: AI-assisterad utveckling; vibe coding; kodningsagenter; Claude Code; GitHub; Vercel; Next.js; PostgreSQL; kontinuerlig leverans; förhandsdistributioner; kodgranskning; databasmigreringar; utvecklingsverktyg; Nashua 360
1. Inledning
Under större delen av mjukvarans historia var det knappa skrivandet. En utvecklares hantverk mättes i förmågan att omsätta en avsikt i korrekt kod, och timmarna gick åt till att skriva, slå upp saker, koppla ihop bibliotek och rätta de små misstag som kompileringsfel och fallerande tester avslöjade. En kompetent kodningsagent tar bort det mesta av detta. Ge den en tydlig instruktion och åtkomst till en kodbas, så producerar den en fungerande ändring på minuter, i idiom den sett en miljon gånger, med standardkoden redan korrekt. Det vardagliga namnet på att arbeta så här, spritt i början av 2025, är vibe coding: att beskriva vad man vill ha och låta modellen framställa det, att styra efter resultat snarare än genom att skriva varje rad. Det är i sanning ett steg i en ny storleksordning, och det är lätt att ta det för hela historien.
Det är inte hela historien, eftersom att få kod att uppstå aldrig var det svåra med mjukvara, bara det mödosamma. Det svåra är att avgöra vad som ska byggas, och att veta att det som byggdes verkligen är rätt, säkert och dugligt att köra. Detta blir inte billigare när genereringen blir det; om något blir det svårare, eftersom det nu finns långt mer kod att förstå, producerad snabbare än en människa skrev den, av en upphovsman som är säker även när han har fel. Mjukvaruutvecklingens flaskhals flyttar. Den satt förr vid genereringen, hur snabbt ett team kunde skriva korrekt kod. Med en agent sitter den vid verifieringen: hur snabbt ett team kan vara säkert på att koden är korrekt och släppa igenom den.
Denna artikel handlar om följderna av det skiftet för verktygen, och den är avsiktligt konkret. Om verifiering är flaskhalsen, så är det mest värdefulla en AI-assisterad miljö kan göra inte att generera snabbare, utan att hjälpa ett team att verifiera snabbare och säkrare, att fånga agentens misstag billigt och tidigt. Vi beskriver den specifika kedja vi på Nashua använder för att bygga och driva vår egen produkt, Nashua 360 Enterprise Platform: Claude Code som agent, GitHub som versionshanterad ryggrad och granskningsgrind, Vercel för en körande förhandsvisning av varje ändring, Next.js som applikationsramverk och Postgres som databas, och vi går in på hur varje del faktiskt fungerar, eftersom det är i detaljen värdet ligger. Varje länk förtjänar sin plats genom att dra åt en loop eller lägga till en grind, inte genom att var för sig vara smart.
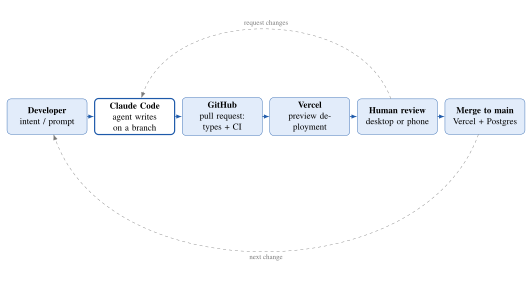
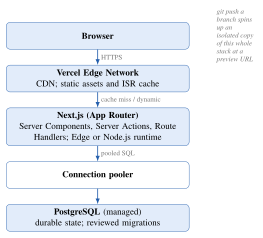
Bidraget är ett argument och en genomarbetad rekommendation, inte ett riktmärke. Avsnitt 2 lägger fram vad AI förändrade och vad det inte gjorde, och lokaliserar flaskhalsen. Avsnitt 3 presenterar kedjan som en loop (figur 1), gör gällande att best-of-breed för agentassisterat arbete betyder konventionellt, och förklarar varför oberoende grindar multipliceras. Avsnitt 4 till 9 tar de fem delarna i tur och ordning och går in i deras inre, inklusive den körtidsarkitektur en distribution faktiskt har (figur 2) och den del som förvånar folk, att en ändring nu kan påbörjas och granskas från en telefon. Avsnitt 10 till 12 behandlar den mänskliga grinden och dess felmoder, de verkliga kostnaderna, och hur kedjan körs i praktiken. Frågan genomgående är: när en agent väl kan skriva koden, vad bör ett team sätta omkring den så att snabbt skrivande inte betyder att man levererar fel?
2. Vad AI förändrade, och vad det inte gjorde
2.1 Skiftet
Den förändring en agent medför uttrycks bäst precist. Det är inte att maskinen nu förstår problemet; det är att kostnaden för att framställa en rimlig, ofta korrekt, implementation av en välspecificerad ändring har rasat. En utvecklare som skulle ha ägnat en eftermiddag åt en funktion kan ha en första version på den tid det tar att beskriva den, och kan kasta flera versioner billigt. Arbetssättet skiftar från att författa till att dirigera: att ange avsikt, läsa resultat, korrigera kursen. Detta är verklig hävstång, och ett team som vägrar den kommer att bli omsprunget.
2.2 Ingen silverkula
Förändringen är också begränsad, och gränsen är gammal. Brooks (1987) drog den åtskillnad som fortfarande gäller här: mjukvarans accidentella komplexitet, det arbete som påtvingas av våra verktyg och språk snarare än av problemet, kan angripas och minskas, men den essentiella komplexiteten, att förstå problemet och specificera en korrekt lösning, kan inte automatiseras bort, eftersom den är problemet. En kodningsagent är det mäktigaste angrepp på accidentell komplexitet som ännu byggts: den absorberar syntaxen, standardkoden, API-uppslagen, idiomen. Den gör ingenting åt essensen. Att veta vad verksamheten behöver, att besluta om rätt design, och att fastställa att en given ändring faktiskt möter behovet utan att bryta sönder något annat, förblir mänskligt arbete, och det är det arbete som alltid var svårt.
2.3 Verifiering blir flaskhalsen
Lägg ihop de två och slutsatsen följer. Generering, den accidentella delen, är nu snabb och billig. Verifiering, där essensen bor, att denna ändring är korrekt, att den gör det som önskades, att den inte brutit sönder något, att den är säker att exponera, är det inte. I varje pipeline sätts genomströmningen av det långsammaste steget, och när genereringen accelererar förbi verifieringen blir verifieringen den bindande flaskhalsen. Ett team som kan generera tio ändringar om dagen men verifiera två kommer att leverera två, och kommer att samla på sig en hög overifierad kod som är en belastning, inte en tillgång. Värre: en agent producerar självsäkert, ytligt korrekt arbete, så kostnaden för att underverifiera, för att merga det som ser rätt ut men inte är det, stiger exakt i takt med att frestelsen att göra det stiger. Återstoden av denna artikel handlar om att bygga en kedja vars uppgift är att höja verifieringstaket och att göra underverifiering svår.
3. Kedjan, och varför konventionellt vinner
3.1 Loopen
En god AI-assisterad miljö är en loop, inte ett verktyg. Figur 1 ritar den vi använder. En utvecklare anger en avsikt. Claude Code, agenten, omsätter den i en ändring på en gren, inte på den levande koden. Ändringen blir en pull request på GitHub, där två automatiska grindar körs utan någons uppmärksamhet: typkontrollen och sviten för kontinuerlig integration. Vercel bygger grenen till en verklig, körande förhandsdistribution, en fullständig kopia av applikationen med ändringen live, nåbar på sin egen URL. En människa granskar ändringen, läser diffen och klickar igenom förhandsvisningen, på en dator eller, allt oftare, på en telefon. Först då mergas den till huvudgrenen, som Vercel distribuerar till produktion, med Postgres i ryggen. Utfallet göder nästa avsikt. Poängen med diagrammet är att agenten upptar en ruta; varje annan ruta är en loop som sluts eller en grind som fångar, och det är där säkerheten och snabbheten kommer ifrån.
3.2 Best-of-breed betyder konventionellt
Det vanliga sättet att välja verktyg är att rangordna dem efter kraft och ta det mäktigaste. För en agentassisterad kedja är kriteriet ett annat, och det är den enskilt mest användbara idén i denna artikel. En agent skriver bäst de verktyg den sett mest av. Dess kompetens på ett ramverk eller en databas är en funktion av hur mycket korrekt kod som använde det verktyget fanns i dess träning, och den mängden följer verktygets popularitet, dess dokumentation och stabiliteten i dess konventioner. Ett utbrett, väldokumenterat, konventionstungt verktyg är därför inte bara ett tryggt mänskligt val; det är det val där agenten är mest kapabel och minst benägen att uppfinna en API som inte finns. Effekten förstärker sig själv: populära verktyg får mer agentgenererad kod, som fungerar, vilket förstärker deras popularitet. För AI-assisterad utveckling har best-of-breed och mest-konventionellt konvergerat, och varje verktyg i tabell 1 valdes med det i åtanke. Detta är också en varning: det exotiska ramverk en mänsklig expert kunde hantera briljant är ofta just där en agent är svagast, eftersom den sett minst av det.
3.3 Varför oberoende grindar multipliceras
Kedjan litar inte på någon enskild kontroll. Den verifierar en ändring genom flera grindar som ser på genuint olika saker: typkontrollen kontrollerar former, testerna i den kontinuerliga integrationen kontrollerar beteende, förhandsdistributionen visar det körande resultatet, och den mänskliga granskaren bedömer avsikt. Eftersom grindarna i hög grad är oberoende multipliceras deras missar snarare än adderas: ett fel når produktion endast om varje grind misslyckas med att fånga det, så fyra måttliga grindar som var och en fångar det mesta de ser släpper bara igenom en liten bråkdel av produkten av det de missar. Detta är försvar-på-djupet-principen, sedan länge känd inom säkerhetsteknik som skiktningen av ofullkomliga barriärer (Reason, 2000), och den har en skarp praktisk följd. Att ta bort eller försvaga en grind, att hoppa över förhandsvisningen, att stänga av en strikt typ, att godkänna utan att läsa, lägger inte till en liten risk; det multiplicerar läckagetakten med inversen av vad den grinden förr fångade. Det billigaste sättet att förbli säker är att hålla flera olika, ofullkomliga grindar ärliga, vilket är precis vad kedjan är arrangerad att göra.
Tabell 1. Kedjan. Varje länk är vald för den loop den sluter eller den grind den lägger till, och för att vara konventionell nog att agenten hanterar den väl. Den sista kolumnen namnger vad länken huvudsakligen skyddar mot.
| Länk | Vad vi använder | Loop den sluter eller grind den lägger till | Vad den skyddar mot |
|---|---|---|---|
| Kodningsagent | Claude Code (CLI, moln och mobil) | Omsätter avsikt i en ändring på en gren; kör själv kontroller och tester innan överlämning | En människa som gör det accidentella arbetet för hand; långsam iteration |
| Versionshantering och granskning | GitHub (grenar, pull requests, Actions) | Varje ändring är en granskningsbar diff; inget når huvudgrenen ogranskat; CI körs på var och en | Ogranskad ändring som når produktion; förlorad historik; inget granskningsspår |
| Förhandsvisning och distribution | Vercel (git-ansluten) | En isolerad, körande förhandsvisning av varje pull request på sin egen URL; produktionsdistribution och återställning med ett klick | Att granska kod man inte kan se köra; riskfyllda releaser |
| Webbramverk | Next.js (TypeScript) | Typer som den första automatiska grinden; konventionell, filbaserad struktur agenten navigerar väl | Hela klasser av fel som typkontrollen avvisar; att agenten går vilse |
| Databas | PostgreSQL (hanterad) | Varaktigt, transaktionellt tillstånd med granskade, versionerade migreringar | Dataförlust; tyst schemaglidning; oupprepbara miljöer |
| Mänsklig granskningsgrind | En människa, vid pull requesten | Bedömningen ingen grind automatiserar: är detta vad vi ville ha, och är det säkert? | Självsäkert felaktig kod som passerade varje automatisk kontroll |
4. Agenten: hur Claude Code passar in
Claude Code är agenten: ett verktyg som läser kodbasen, skriver och redigerar filer, kör kommandon, exekverar testerna och öppnar pull requests, arbetande utifrån en instruktion och korrigerande sig själv mot de resultat det ser. Hur det körs betyder mer än modellens råa förmåga, och tre saker om det är värda en praktikers uppmärksamhet.
Det första är sammanhang. En agent är bara så god som det den vet om din kodbas, och den enskilt mest hävstångsgivande artefakten är en incheckad konventionsfil, i vårt fall en projekt-CLAUDE.md, som berättar husreglerna för agenten: hur projektet är upplagt, hur man kör typkontrollen och testerna, vad som ska distribueras och hur, vad som aldrig får röras. Agenten läser den vid varje körning, så en korrigering nedskriven en gång upphör att återkomma. Omkring den ligger en vidare yta, återanvändbara skills för upprepade uppgifter, hooks som körs på verktygsanrop för att upprätthålla en regel mekaniskt, och MCP-servrar som ger agenten typad åtkomst till yttre system, GitHub bland dem, så att den kan öppna och uppdatera pull requests som förstklassiga handlingar snarare än genom skärmskrapning. Sammanhangsteknik, att avgöra vad agenten bör veta och kunna göra, är det verkliga arbetet med att införa en, och det är vanlig mjukvaruhygien: skriv ner konventionerna, gör kontrollerna körbara, håll ytan liten.
Det andra är att agenten körs i loopen snarare än isolerat. Den förväntas själv köra typkontrollen och testerna, läsa vad de rapporterar, och rätta det, innan någon människa tittar, så att kedjans automatiska grindar redan är gröna när en pull request öppnas. För större uppgifter kan den fördela ut arbete till subagenter som var och en bär sitt eget sammanhang och rapporterar tillbaka, vilket håller huvudtråden fokuserad och sammanhanget rent. Disciplinen är att låta den snabba, billiga återkopplingen, typer och tester, ske inuti agentens egen loop, och att reservera den långsamma, dyra återkopplingen, människan, till slutet.
Det tredje är var det körs. Utöver terminalen körs Claude Code som en molnsession nåbar från en mobilapp, vilket ändrar arbetsdagens form. En ändring kan påbörjas från en telefon på väg någonstans, lämnas att köra i molnet, och dess pull request och förhandsvisning granskas och godkännas från samma telefon senare. Vi är avsiktliga med detta inte för att mobilt arbete är en nyhet utan för att det förkortar loopen: glappet mellan att lägga märke till något och att påbörja ändringen, och mellan att en ändring är klar och att någon godkänner den, krymper från timmar till minuter, vilket i en verifieringsbunden värld är precis det glapp som är värt att sluta.
5. Ryggraden: GitHub
GitHub är den del av kedjan som gör allt annat säkert, och den är den minst glamorösa. Den håller den gemensamma sanningskällan, förvaret, och den upprätthåller regeln som hela argumentet vilar på: huvudgrenen, den som levererar, är skyddad, och kan nås endast genom en pull request som en människa har godkänt och vars obligatoriska statuskontroller har passerat. Agenten redigerar aldrig produktionskod direkt; den föreslår, på en gren, och förslaget är en diff en människa kan läsa och en maskin kan testa.
De obligatoriska kontrollerna är där de automatiska grindarna bor. På varje pull request kör GitHub Actions den svit vi insisterar på innan något mergas: typkontrollen, lintern, testsviten och ett produktionsbygge, var och en en obligatorisk status som blockerar merge-knappen tills den är grön. Eftersom dessa upprätthålls av plattformen snarare än av någons disciplin kan de inte hoppas över i hast, och eftersom agenten vet att de kommer att köras tillfredsställer den dem först. Pull requesten är förändringens enhet: liten, självständig, individuellt granskningsbar och individuellt återställbar, vilket är det som håller granskningen billig och historiken läsbar. Och eftersom varje ändring är en commit med en upphovsman och ett meddelande är historiken ett granskningsspår och ångrandet är totalt, allt agenten gjorde kan ses, tillskrivas och återställas. En kodningsagent är en snabb, mäktig och felbar aktör, och GitHub är den struktur som gör det säkert att släppa en lös, genom att säkerställa att inget den gör är ogranskat, otestat eller oåterkalleligt.
6. Ögonen: Vercel
Att läsa en diff säger dig vad som ändrades; det säger dig inte vad ändringen gör. Vercel sluter det glappet genom att bygga varje pull request till en förhandsdistribution: en fullständig, isolerad, körande instans av applikationen med ändringen tillämpad, på sin egen URL, skapad automatiskt och uppdaterad vid varje push. Detta är grinden som fångar det typer och tester inte gör, layouten som gick sönder, flödet som blev ett steg längre, det som är tekniskt korrekt och fel i användning, och det är till största delen varför kedjan kan röra sig snabbt utan att röra sig blint. En granskare, och agenten, klickar igenom det faktiska resultatet snarare än att föreställa sig det utifrån koden.
Det som gör förhandsvisningen pålitlig är att den är ett verkligt bygge av hela stacken, inte en attrapp (figur 2): samma ramverk, samma körtid, sina egna miljövariabler, och, väl utfört, sin egen isolerade eller förgrenade databas så att körning av den inte kan vidröra produktionsdata. Distributioner är oföränderliga: var och en är ett distinkt, adresserbart bygge, så att befordra en granskad förhandsvisning till produktion är en pekarförflyttning snarare än ett ombygge, och en dålig release är en ögonblicklig återställning till den föregående oföränderliga distributionen snarare än en panikartad hotfix. Vid merge till huvudgrenen bygger samma maskineri som byggde förhandsvisningen produktionen, så det som granskades är det som levereras. I modellen för denna kedja är förhandsdistributioner en billig, automatisk verifieringsgrind med hög fångstgrad för en klass av fel ingen annan grind ser.
7. Sömlöst genom git: varför de tre passar ihop
Skälet till att Claude Code, GitHub och Vercel känns mindre som tre verktyg och mer som ett system är att de delar ett enda gränssnitt, och det gränssnittet är git. Claude Codes naturliga utdata är inte en distribution; det är en gren och en pull request. GitHubs uppgift är att lagra dessa commits, köra kontrollerna och hålla granskningen. Vercel bevakar förvaret och förvandlar varje gren till en förhandsvisning och huvudgrenen till produktion. Ingen av dem behövde läras om de andra: agenten lär sig aldrig ett distributions-API, den öppnar en pull request; Vercel lär sig aldrig om agenten, den bevakar förvaret. Fogen mellan dem är det git-protokoll alla tre redan talar, vilket är varför det inte ändrade något om hur distribution fungerade att lägga till en agent i kedjan, och varför hela vägen från en prompt till produktion inte har några överlämningar i sig.
Följden är att distribution upphör att vara ett steg någon utför och blir en följd av den git-handling de ändå tänkte utföra. En push är ett bygge. En pull request är en förhandsvisningsmiljö, skapad och nedtagen av sig själv. En merge till huvudgrenen är en produktionsdistribution. En revert är en återställning. Ingen kör en release; de mergar, och releasen sker. Det finns ingen byggserver att passa, inget distributionsskript för agenten att få fel, inget separat befordringsverktyg, inget fönster i vilket någon har skrivit koden men ännu inte levererat den. För ett verifieringsbundet team är detta precis rätt ställe att ta bort friktion: den enda avsiktliga, mänskliga handling som återstår i vägen är granskningen, vilket är den enda handling som bör vara avsiktlig, och allt mekaniskt omkring den sköts av verktygen som bevakar git.
Detta är också varför sömlösheten är säker snarare än vårdslös, och de två egenskaperna kommer från samma faktum. Eftersom distribution rider på git ärver den gits garantier: varje produktionsdistribution är knuten till en specifik granskad commit, med en upphovsman och ett meddelande; varje förhandsvisning är knuten till en gren; och eftersom distributioner är oföränderliga är att återställa bara att peka produktion mot ett tidigare commits bygge. Samma koppling som låter en ändring flyta från en telefonskriven prompt till en levande webbplats utan att någon rör en distributionskonsol säkerställer också att inget når den levande webbplatsen annat än genom en granskad, tillskrivbar, återställbar commit. Integrationen är en passform inte för att leverantörerna samordnade den utan för att alla tre byggdes för att behandla git som sanningskällan, och när agenten anslöt sig till den konventionen fanns den pipeline den behövde redan där.
8. Terrängen: Next.js
Agenten måste navigera en kodbas, och kodbasens ramverk är terrängen. Next.js är ett starkt val av två skäl som bägge går tillbaka på verifiering. Det första är att det är TypeScript, och typer är den första och billigaste grinden. Körd i strikt läge avvisar typkontrollen en stor klass av misstag, en felaktig form, ett saknat fält, ett värde som kan vara null, i det ögonblick agenten skriver det, vilket är precis när en korrigering är billigast, innan koden körs och långt innan en människa tittar. Vi driver samma idé till programmets kanter, och validerar extern indata, begärandekroppar, miljövariabler, databasrader, mot ett schema så att otypad data utifrån blir typad och kontrollerad vid gränsen snarare än betrodd. Typer är ingen byråkrati här; de är grinden som förvandlar agentens vanligaste fel, en rimlig form som är subtilt fel, till ett rött krumelurstreck den rättar själv.
Det andra skälet är att Next.js är konventionellt, och dess modell, om än rik, är tillräckligt upptrampad för att agenten ska skriva den ledigt. Det är värt att vara konkret om den modellen, eftersom det är där mycket av tekniken bor. App Router renderar på servern som förval: Server Components körs på servern och skickar aldrig sin kod till webbläsaren, och håller dataåtkomst och hemligheter på serversidan, medan Client Components, explicit markerade, bär interaktiviteten. Muteringar går genom Server Actions, serverfunktioner som ett formulär eller en knapp kan anropa direkt, och Route Handlers tillhandahåller API-ytan. Varje rutt väljer hur den renderar, statiskt vid byggtid, inkrementellt regenererad enligt ett schema, eller dynamiskt per begäran, och var den körs, den lättviktiga Edge-körtiden nära användaren eller den fullständigare Node.js-körtiden, med middleware som körs före begäran för att hantera sådant som autentisering och språkinställning. Detta är många reglage, men de är offentliga, dokumenterade, stabila reglage agenten har sett användas korrekt i stor skala, så den griper efter det rätta, och ramverket är mäktigt nog att bygga en verklig produkt medan det förblir terrängen där agenten är mest kapabel, vilket, enligt argumentet i avsnitt 3, är den kombination som betyder något.
9. Tillståndet: Postgres
Allt ovan rör kod, som är säker att ändra eftersom den är versionerad och återställbar. Data är det inte: en borttagen kolumn eller en dålig migrering kan förstöra något ingen commit kan återställa. Postgres är det varaktiga, transaktionella tillståndet längst ner i kedjan, och disciplinen omkring det är avsiktligt strängare än omkring kod. PostgreSQL förtjänar sin plats på samma sätt som resten av kedjan, det är det konventionella, stridstestade, utmärkt dokumenterade valet, så agenten skriver korrekt SQL och korrekta migreringar mot det, och en hanterad instans tar bort den operativa mödan utan att ändra modellen.
Omsorgen läggs på förändring. Schemaändringar är migreringar: ordnade, versionerade filer incheckade i förvaret och granskade som vilken annan ändring som helst, körda mot förhandsvisningen före produktion, och skrivna för att vara återställbara. En live-databas kan inte ändras så som en färsk kan, så en riskfylld ändring görs som en sekvens av säkra, mönstret expand and contract (Ambler & Sadalage, 2006): lägg till den nya kolumnen eller tabellen och börja skriva till den, fyll på i efterhand, flytta över läsningarna, och först då, i en senare distribution, ta bort den gamla formen, så att vid varje mellansteg den körande koden och schemat är kompatibla och steget är återställbart. Postgres hjälper till genom att göra de flesta schemaändringar transaktionella, så att en misslyckad migrering rullas tillbaka rent snarare än lämnar databasen halvändrad. Två operativa punkter betyder något i en serverless-miljö, där många kortlivade funktionsinstanser var och en vill ha en anslutning: en anslutningspoolare är inte valfri, eftersom en databas har en hård anslutningsgräns som en flotta serverless-arbetare annars kommer att tömma; och radnivåsäkerhet låter databasen själv upprätthålla vem som får se vilka rader, ett skyddsnät som inte beror på att applikationen får varje fråga rätt. Regeln vi håller är enkel och värd att uttala: agenten får föreslå en migrering, men en migrering är den enda sortens ändring en människa alltid läser med full uppmärksamhet, eftersom det är den enda sorten kedjan inte helt kan ångra.
10. Den mänskliga grinden och hur den fallerar
Varje automatisk grind i denna kedja finns till för att göra den mänskliga grinden billig, inte för att ta bort den. Granskaren vid pull requesten gör det enda ingen grind automatiserar: att bedöma om ändringen är vad verksamheten faktiskt ville ha och om den är säker att exponera, frågor som typer, tester och förhandsvisningar upplyser men inte besvarar. Kedjans hela syfte är att leverera till den granskaren en liten, körande, förkontrollerad ändring så att bedömningen blir snabb och välgrundad. Men grinden har karakteristiska felmoder, och att namnge dem är en del av att använda kedjan väl.
Det första är gummistämpling. När agenten vanligen har rätt lär sig granskaren att godkänna snabbt, och granskningen urartar till en formalitet som inte fångar något. Försvaret är att hålla ändringar små, så att det förblir billigt att läsa dem ordentligt, och att behandla förhandsvisningen som obligatorisk, inte valfri: en granskning som inte klickade igenom den körande ändringen är ingen granskning. Det andra är övertro, föreställningen att eftersom koden klarade typkontrollen och testerna måste den vara korrekt; de grindarna fångar former och beteenden men inte avsikt, och människan är den enda grinden på avsikt. Det tredje är skalutmattning: en agent kan öppna fler pull requests än ett team seriöst kan granska, och en hög halvgranskade ändringar är den verifieringsbundna regimen som gör sig gällande igen. Svaret är inte att granska snabbare utan att generera mer avsiktligt, att låta agenten producera bara det teamet faktiskt kan verifiera, eftersom overifierad ändring är en belastning oavsett dess volym.
11. Kostnader och avvägningar
Kedjan är en uppsättning val, och ärlighet kräver att man anger vad de kostar. Det mest uppenbara är bindning: Next.js och Vercel kommer från samma företag, och att bygga på dem köper en smidig, integrerad väg till priset av en viss inlåsning, både till ett ramverk som rör sig snabbt och ibland bryter kompatibiliteten mellan större versioner, och till en värdplattform vars prissättning och primitiver man anammar. Vi bedömer bytet värt det för hastigheten och kvaliteten i förhandsvisningsloopen, men det är ett verkligt beroende, och ett team bör hålla sin domänlogik och sina data portabla så att ramverket och värden förblir utbytbar infrastruktur snarare än produkten. Den andra kostnaden är den disciplin grinden kräver: kedjan är bara så säker som den granskning den utmynnar i, och ett team som låter den mänskliga grinden förfalla till gummistämpling har ett snabbt sätt att leverera självsäkra misstag, vilket är värre än ett långsamt sätt att leverera genomtänkta. Den tredje är agentens åtkomst: ett verktyg som kan redigera förvaret och utlösa distributioner är en mäktig aktör, och den måste avgränsas som en, med grenskydd, med behörigheter enligt minsta privilegium, med hemligheter hållna utanför förvaret och utom räckhåll för agenten, och med behörighets- och infrastrukturändringar granskade med särskild omsorg. Den fjärde är datats oåterkallelighet, behandlad ovan: det enda ställe där kedjans skyddsnät har ett hål, och stället att lägga mest mänsklig uppmärksamhet. Ingen av dessa är ett skäl att inte införa kedjan; var och en är ett skäl att införa den avsiktligt.
12. Hur vi driver Nashua 360-plattformen på den
Kedjan i denna artikel är inte ett förslag vi har teoretiserat fram; det är den vi bygger och driver vår egen produkt på. Nashua 360 Enterprise Platform är en Next.js-applikation, distribuerad på Vercel, med Postgres i ryggen, med sin källkod på GitHub, och den utvecklas med Claude Code som agent, inklusive från mobilappen när en ändring bättre påbörjas eller godkänns borta från ett skrivbord. En incheckad konventionsfil berättar husreglerna för agenten; varje ändring av plattformen är en gren och en pull request; varje pull request får sin typkontroll, sin körning av kontinuerlig integration, och sin förhandsdistribution på en isolerad kopia av stacken; inget når produktionsgrenen utan att en människa läser diffen och klickar igenom förhandsvisningen; och migreringar är de ändringar vi läser hårdast. Vi satte inte ihop denna kedja för att vara på modet. Vi satte ihop den eftersom, när vi väl accepterat att en agent hade gjort generering billig och verifiering till flaskhalsen, varje länk följde av frågan om hur man verifierar snabbt och säkert, och eftersom samma resonemang som gör den rätt för oss, konventionella verktyg agenten hanterar väl, inlindade i loopar och grindar som fångar dess misstag, gör den rätt för de flesta team som bygger webbmjukvara i dag. Att den också låter en seriös produkt drivas framåt från en telefon på ett tåg är inte skälet till att vi valde den, men det är ett rimligt tecken på hur långt arbetets form har förändrats.
13. Invändningar och svar
Det här är bara kontinuerlig leverans med en agent fastskruvad. Till stor del, avsiktligt. De praktiker kedjan vilar på, versionshantering, små granskade ändringar, kontinuerlig integration, automatiserad distribution med förhandsvisningar och återställning, är den etablerade disciplinen i modern mjukvaruleverans (Humble & Farley, 2010; Forsgren et al., 2018), och det är poängen: agenten ersätter inte den disciplinen, den höjer premien på den, eftersom det är disciplinen som levererar den verifiering agentens snabbhet nu kräver. Bidraget är inte en ny praktik utan argumentet för varför de gamla praktikerna betyder mer, inte mindre, när generering väl är billig.
En bättre modell kommer att göra verktygen onödiga. Det kommer den inte, eftersom verktygen adresserar den del en bättre modell inte rör. En mer kapabel agent genererar snabbare och, i en verifieringsbunden värld, höjer snabbare generering inte vad som faktiskt levereras; bara snabbare verifiering gör det. Den bättre modellen producerar också mer kod, snabbare, för en människa att kontrollera, vilket gör grindarna mer nödvändiga, inte mindre. Kedjan är ett vad på verifiering, och det vadet blir bättre, inte sämre, allteftersom genereringen förbättras.
Ni är inlåsta i en enda leverantörs stack. Delvis, och det sade vi. Bindningen mellan Next.js och Vercel är en verklig kostnad accepterad för en verklig fördel, den integrerade förhandsvisningsloopen som är central för hela argumentet. Åtgärden är att hålla den väsentliga logiken, domänkoden och databasen, portabel, och att behandla ramverket och värden som utbytbar infrastruktur. Ett team med en annan riskaptit kan behålla kedjans form, agent, versionshantering, isolerad förhandsvisning, typat ramverk, granskad databas, på andra komponenter.
14. Begränsningar
Detta är råd riktade till praktiker, och dess gränser bör anges. Det är en genomtänkt rekommendation grundad i vår egen användning, inte en kontrollerad jämförelse; vi har inte mätt kedjan mot alternativ. De specifika verktygen är aktuella per slutet av 2026, och detta är ett snabbrörligt fält: argumentet, att verifiering är flaskhalsen och att kedjan bör läsas som loopar och grindar, är tänkt att överleva vilket enskilt verktyg som helst, men de enskilda verktygen kommer att ändras, och en läsare bör behålla argumentet och ompröva delarna. Rekommendationen är avgränsad till den sortens mjukvara vi bygger, webbapplikationer med en databas, och bär mindre direkt över till domäner med andra villkor, såsom system där kostnaden för en verifieringsgrind i sig är oöverkomlig, eller där ingen agent har sett nog av stacken för att kunna anförtros den. Och kedjans säkerhet vilar på en mänsklig grind som kedjan gör billig men inte kan göra automatisk; ett team som inte är villigt att hålla den grinden ärlig bör vänta sig snabbheten utan säkerheten.
15. Slutsats
En kodningsagent gör skrivandet av mjukvara snabbt, och gör därmed det svåra synligt. Generering, den del som förr dominerade dagen, blir billig; verifiering, att avgöra vad som ska byggas och att vara säker på att resultatet är rätt, blir det inte, och blir flaskhalsen. Lärdomen för verktygen är att värdet i en AI-assisterad miljö inte ligger i agenten utan i kedjan omkring den som låter ett team verifiera i den takt agenten genererar och fångar dess misstag innan användarna gör det. Vi bygger och driver Nashua 360-plattformen på en sådan kedja: Claude Code att skriva med, i en loop med kontrollerna och nåbar från en telefon; GitHub att göra varje ändring till en granskad, återställbar diff bakom en skyddad gren; Vercel att ge varje ändring sin egen körande förhandsvisning och varje release en ögonblicklig återställning; Next.js som en typad, konventionell terräng vars typer är den första grinden; och Postgres som varaktigt tillstånd ändrat genom granskade, återställbara migreringar. Varje länk sluter en loop eller lägger till en grind, grindarna är oberoende så att ingen av dem måste vara perfekt, och helheten är vald på ett kriterium särskilt för detta ögonblick: att för en agent är det konventionella verktyget det kapabla. Skriv snabbt, verifiera snabbare, och låt inget nå produktion som en människa inte har sett köra. Det är hela saken, och det räcker.
Bilaga A. En checklista för införande
Praktikerna nedan är det som gör kedjan säker snarare än bara snabb. Ingen är ny; disciplinen är värdet.
Tabell 2. En checklista för införande. Varje praktik håller en grind ärlig eller en loop kort; den högra kolumnen är det misslyckande den förhindrar.
| Praktik | Vad den förhindrar |
|---|---|
| Skydda huvudgrenen; merga endast via granskad pull request med obligatoriska kontroller | Ogranskad eller otestad ändring som når produktion |
| Håll en incheckad konventionsfil för agenten | Att upprepa samma korrigeringar; sammanhangsglidning |
| Håll ändringar små | Granskning som urartar till gummistämpling |
| Låt agenten köra typer och tester före överlämning | En människa som gör maskinens verifiering |
| Behandla förhandsvisningen som obligatorisk vid granskning | Att godkänna kod ingen såg köra |
| Ge förhandsvisningar isolerade data | En granskning som vidrör produktionsdata |
| Läs varje migrering med full uppmärksamhet; expand sedan contract | Den enda ändring kedjan inte kan ångra |
| Håll hemligheter utanför förvaret och agentens räckhåll; minsta privilegium | En mäktig aktör med behörigheter den inte behöver |
| Generera bara det du kan verifiera | En hög overifierad, ansvarsbärande ändring |
Referenser
Ambler, S. W., & Sadalage, P. J. (2006). Refactoring databases: Evolutionary database design. Addison-Wesley. ISBN 978-0-321-29353-5.
Bacchelli, A., & Bird, C. (2013). Expectations, outcomes, and challenges of modern code review. In Proceedings of the 35th International Conference on Software Engineering (ICSE) (pp. 712–721). IEEE. https://doi.org/10.1109/ICSE.2013.6606617
Beck, K. (2000). Extreme programming explained: Embrace change. Addison-Wesley. ISBN 978-0-201-61641-5.
Brooks, F. P. (1987). No silver bullet: Essence and accidents of software engineering. Computer, 20(4), 10–19. https://doi.org/10.1109/MC.1987.1663532
Chen, M., Tworek, J., Jun, H., et al. (2021). Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374. https://arxiv.org/abs/2107.03374
Anthropic (2026). Claude Code documentation. https://code.claude.com/docs
Forsgren, N., Humble, J., & Kim, G. (2018). Accelerate: The science of lean software and DevOps: Building and scaling high performing technology organizations. IT Revolution Press. ISBN 978-1-942788-33-1.
Fowler, M. (2006). Continuous integration. martinfowler.com. https://martinfowler.com/articles/continuousIntegration.html
GitHub (2026). GitHub documentation. https://docs.github.com
Humble, J., & Farley, D. (2010). Continuous delivery: Reliable software releases through build, test, and deployment automation. Addison-Wesley. ISBN 978-0-321-60191-9.
Vercel (2026). Next.js documentation. https://nextjs.org/docs
Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv preprint arXiv:2302.06590. https://arxiv.org/abs/2302.06590
PostgreSQL Global Development Group (2026). PostgreSQL documentation. https://www.postgresql.org/docs/
Reason, J. (2000). Human error: Models and management. BMJ, 320(7237), 768–770. https://doi.org/10.1136/bmj.320.7237.768
Sadowski, C., Söderberg, E., Church, L., Sipko, M., & Bacchelli, A. (2018). Modern code review: A case study at Google. In Proceedings of the 40th International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP) (pp. 181–190). ACM. https://doi.org/10.1145/3183519.3183525
Vercel (2026). Vercel documentation. https://vercel.com/docs