
giugno 2026
A Best-of-Breed Chain for AI-Assisted Software Development
Perché la parte difficile del vibe coding è la verifica, non la generazione, e come Claude Code, GitHub, Vercel, Next.js e Postgres chiudono il ciclo su cui costruiamo la piattaforma Nashua 360
Sommario
Un agente di codifica capace cambia l’economia dello sviluppo software: scrivere codice, l’attività che un tempo dominava la giornata di uno sviluppatore, diventa rapido e quasi gratuito, mentre le attività che vi stanno attorno, decidere cosa costruire e assicurarsi che il risultato sia corretto, no. Il vincolo si sposta dalla generazione alla verifica. Questo articolo sostiene che il valore di un setup di sviluppo assistito dall’IA non risiede nel modello che scrive il codice, ma nella catena di strumenti attorno a esso che consente a un team di verificare, con rapidità, ciò che l’agente produce, e che ne intercetta gli errori prima che raggiungano gli utenti. È un resoconto tecnico e dichiaratamente di parte della catena su cui noi di Nashua costruiamo e facciamo funzionare il nostro prodotto, la Nashua 360 Enterprise Platform, e del perché ciascun anello è ciò che è: Claude Code come agente, eseguito in un ciclo con il resto della catena e raggiungibile da un’app mobile, così che una modifica possa essere avviata e un risultato revisionato da un telefono; GitHub come spina dorsale, con un branch principale protetto, controlli di stato obbligatori e la pull request come unità di cambiamento; Vercel che dà a ogni pull request il proprio preview deployment isolato e funzionante; Next.js come framework tipizzato e convenzionale il cui type checker è il primo e meno costoso cancello e il cui modello di rendering e di runtime l’agente percorre con scioltezza; e PostgreSQL come stato durevole, modificato attraverso migrazioni revisionate e reversibili. Entriamo nelle parti a cui tengono i professionisti: come si fornisce contesto all’agente e lo si tiene onesto, che cosa gira nella continuous integration, che cos’è davvero un preview deployment, come Next.js esegue il rendering e dove viene eseguito, e come modificare un database in produzione senza romperlo. Sosteniamo che per il lavoro assistito dall’IA best-of-breed significa convenzionale, perché l’agente scrive meglio gli strumenti che ha visto di più, e siamo franchi sui costi: l’accoppiamento al fornitore, la disciplina che il cancello della revisione umana richiede, il rischio di un agente con ampio accesso e l’irreversibilità dei dati. Questo è un consiglio rivolto ai professionisti, non un benchmark.
Parole chiave: sviluppo assistito dall’IA; vibe coding; agenti di codifica; Claude Code; GitHub; Vercel; Next.js; PostgreSQL; continuous delivery; preview deployment; code review; migrazioni di database; strumenti per sviluppatori; Nashua 360
1. Introduzione
Per gran parte della storia del software, la risorsa scarsa era la scrittura. L’arte di uno sviluppatore si misurava nella capacità di trasformare un’intenzione in codice corretto, e le ore andavano nel digitare, nel cercare informazioni, nel collegare tra loro le librerie, nel correggere i piccoli errori che gli errori di compilazione e i test falliti rivelavano. Un agente di codifica capace rimuove gran parte di tutto ciò. Dategli un’istruzione chiara e l’accesso a una codebase e produrrà una modifica funzionante in pochi minuti, in idiomi che ha visto un milione di volte, con il boilerplate già corretto. Il nome colloquiale per lavorare in questo modo, reso popolare all’inizio del 2025, è vibe coding: descrivere ciò che si vuole e lasciare che il modello lo produca, orientandosi in base ai risultati anziché scrivendo ogni riga. È genuinamente un salto di livello, ed è facile scambiarlo per l’intera storia.
Non è l’intera storia, perché far comparire il codice non è mai stata la parte difficile del software, solo quella laboriosa. Le parti difficili sono decidere cosa costruire, e sapere che ciò che è stato costruito è davvero giusto, sicuro e adatto a essere eseguito. Queste non diventano più economiche quando lo diventa la generazione; semmai diventano più difficili, perché ora c’è molto più codice da comprendere, prodotto più in fretta di quanto una persona lo scrivesse, da un autore che è sicuro di sé anche quando sbaglia. Il collo di bottiglia dello sviluppo software si sposta. Un tempo stava alla generazione, quanto in fretta un team potesse scrivere codice corretto. Con un agente sta alla verifica: quanto in fretta un team può essere certo che il codice sia corretto e lasciarlo passare.
Questo articolo riguarda la conseguenza di quello spostamento per gli strumenti, ed è deliberatamente concreto. Se la verifica è il vincolo, allora la cosa più preziosa che un setup assistito dall’IA possa fare non è generare più in fretta, è aiutare un team a verificare più in fretta e in modo più sicuro, intercettando gli errori dell’agente a basso costo e per tempo. Descriviamo la catena specifica che noi di Nashua usiamo per costruire e operare il nostro prodotto, la Nashua 360 Enterprise Platform, Claude Code come agente, GitHub come spina dorsale sotto controllo di versione e cancello di revisione, Vercel per un preview funzionante di ogni modifica, Next.js come framework applicativo, e Postgres come database, ed entriamo in come ciascun pezzo funziona davvero, perché è nel dettaglio che sta il valore. Ciascun anello si guadagna il proprio posto stringendo un ciclo o aggiungendo un cancello, non per essere individualmente ingegnoso.
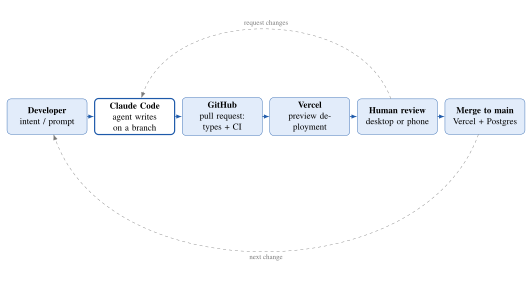
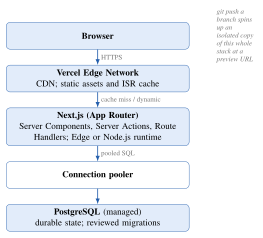
Il contributo è un argomento e una raccomandazione elaborata, non un benchmark. La Sezione 2 espone cosa ha cambiato l’IA e cosa no, e individua il collo di bottiglia. La Sezione 3 presenta la catena come un ciclo (Figura 1), argomenta che per il lavoro assistito da agenti best-of-breed significa convenzionale, e spiega perché i cancelli indipendenti si compongono. Le Sezioni da 4 a 9 affrontano i cinque pezzi uno per uno ed entrano nei loro meccanismi interni, compresa l’architettura di runtime che un deployment effettivamente ha (Figura 2) e la parte che sorprende le persone, che una modifica ora può essere avviata e revisionata da un telefono. Le Sezioni da 10 a 12 trattano il cancello umano e le sue modalità di fallimento, i costi reali, e come la catena funziona nella pratica. La domanda di fondo è: una volta che un agente può scrivere il codice, cosa dovrebbe mettergli attorno un team affinché scrivere in fretta non significhi spedire sbagliato?
2. Cosa ha cambiato l’IA, e cosa no
2.1 Lo spostamento
Il cambiamento che un agente porta è meglio enunciarlo con precisione. Non è che la macchina ora comprenda il problema; è che il costo di produrre un’implementazione plausibile, e spesso corretta, di una modifica ben specificata è crollato. Uno sviluppatore che avrebbe dedicato un pomeriggio a una funzionalità può averne una prima versione nel tempo necessario a descriverla, e può scartarne diverse versioni a basso costo. La modalità di lavoro passa dall’autore al direttore: enunciare l’intento, leggere i risultati, correggere la rotta. Si tratta di una leva reale, e un team che la rifiuta verrà superato.
2.2 Nessuna pallottola d’argento
Il cambiamento è anche circoscritto, e il confine è antico. Brooks (1987) tracciò la distinzione che qui governa ancora: la complessità accidentale del software, la fatica imposta dai nostri strumenti e linguaggi anziché dal problema, può essere attaccata e ridotta, ma la complessità essenziale, comprendere il problema e specificare una soluzione corretta, non può essere automatizzata via, perché è il problema. Un agente di codifica è l’attacco più potente alla complessità accidentale mai costruito: assorbe la sintassi, il boilerplate, la consultazione delle API, gli idiomi. Non fa nulla riguardo all’essenza. Sapere di cosa ha bisogno l’azienda, decidere il design giusto e accertare che una data modifica soddisfi davvero il bisogno senza romperne un’altra cosa, restano lavoro umano, e sono il lavoro che è sempre stato difficile.
2.3 La verifica diventa il vincolo
Mettete insieme le due cose e la conclusione segue. La generazione, la parte accidentale, ora è rapida ed economica. La verifica, che è dove vive l’essenza, che questa modifica sia corretta, che faccia ciò che si voleva, che non abbia rotto nulla, che sia sicura da esporre, non lo è. In qualunque pipeline la portata è fissata dalla fase più lenta, e quando la generazione accelera oltre la verifica, la verifica diventa il vincolo stringente. Un team che può generare dieci modifiche al giorno ma verificarne due ne spedirà due, e accumulerà un arretrato di codice non verificato che è un passivo, non un attivo. Peggio, un agente produce lavoro sicuro di sé e superficialmente corretto, cosicché il costo di sotto-verificare, di fare il merge di ciò che sembra giusto e non lo è, cresce esattamente mentre cresce la tentazione di farlo. Il resto di questo articolo riguarda la costruzione di una catena il cui compito è alzare il soffitto della verifica e rendere difficile la sotto-verifica.
3. La catena, e perché vince il convenzionale
3.1 Il ciclo
Un buon setup assistito dall’IA è un ciclo, non uno strumento. La Figura 1 disegna quello che usiamo. Uno sviluppatore enuncia un intento. Claude Code, l’agente, lo trasforma in una modifica su un branch, non sul codice in produzione. La modifica diventa una pull request su GitHub, dove due cancelli automatici girano senza l’attenzione di nessuno: il type checker e la suite di continuous integration. Vercel costruisce il branch in un preview deployment reale e funzionante, una copia completa dell’applicazione con la modifica attiva, raggiungibile al proprio URL. Un essere umano revisiona la modifica, leggendo il diff e cliccando attraverso il preview, su un desktop o, sempre più spesso, su un telefono. Solo allora viene fatto il merge sul branch principale, che Vercel distribuisce in produzione, con Postgres a sostegno. L’esito alimenta l’intento successivo. Il senso del diagramma è che l’agente occupa una sola casella; ogni altra casella è un ciclo che si chiude o un cancello che intercetta, ed è da lì che vengono la sicurezza e la velocità.
3.2 Best-of-breed significa convenzionale
Il modo consueto di scegliere gli strumenti è ordinarli per potenza e prendere il più capace. Per una catena assistita da un agente il criterio è diverso, ed è la singola idea più utile di questo articolo. Un agente scrive meglio gli strumenti che ha visto di più. La sua competenza su un framework o un database è funzione di quanto codice corretto che usa quello strumento figurava nel suo addestramento, e quella quantità segue la popolarità dello strumento, la sua documentazione e la stabilità delle sue convenzioni. Uno strumento mainstream, ben documentato e ricco di convenzioni non è quindi soltanto una scelta umana sicura; è la scelta su cui l’agente è più capace e meno incline a inventare un’API che non esiste. L’effetto si compone: gli strumenti popolari ricevono più codice generato da agenti, che funziona, il che ne rafforza la popolarità. Per lo sviluppo assistito dall’IA, best-of-breed e più-convenzionale sono convergenti, e ogni strumento della Tabella 1 è stato scelto con questo in mente. È anche un avvertimento: il framework esotico che un esperto umano potrebbe maneggiare brillantemente è spesso esattamente il punto in cui un agente è più debole, perché ne ha visto il meno.
3.3 Perché i cancelli indipendenti si compongono
La catena non si fida di nessun singolo controllo. Verifica una modifica attraverso diversi cancelli che guardano a cose genuinamente differenti: il type checker controlla le forme, i test di continuous integration controllano il comportamento, il preview deployment mostra il risultato in funzione, e il revisore umano giudica l’intento. Poiché i cancelli sono in larga misura indipendenti, le loro mancate intercettazioni si moltiplicano anziché sommarsi: un difetto raggiunge la produzione solo se ogni cancello non riesce a intercettarlo, cosicché quattro cancelli modesti che ciascuno intercetta la maggior parte di ciò che vede lasciano passare solo una piccola frazione del prodotto di ciò che mancano. È il principio della difesa in profondità, noto da tempo nell’ingegneria della sicurezza come la stratificazione di barriere imperfette (Reason, 2000), e ha un corollario pratico netto. Rimuovere o indebolire un cancello, saltare il preview, disattivare un tipo stretto, approvare senza leggere, non aggiunge un po’ di rischio; moltiplica il tasso di fuga per il reciproco di ciò che quel cancello intercettava. Il modo meno costoso per restare al sicuro è tenere onesti diversi cancelli, differenti e imperfetti, che è esattamente ciò per cui la catena è disposta.
Tabella 1. La catena. Ciascun anello è scelto per il ciclo che chiude o il cancello che aggiunge, e per essere abbastanza convenzionale da far sì che l’agente lo gestisca bene. L’ultima colonna nomina ciò contro cui l’anello protegge principalmente.
| Anello | Cosa usiamo | Ciclo che chiude o cancello che aggiunge | Contro cosa protegge |
|---|---|---|---|
| Agente di codifica | Claude Code (CLI, cloud e mobile) | Trasforma l’intento in una modifica su un branch; esegue da sé controlli e test prima di consegnare | Un essere umano che fa a mano il lavoro accidentale; iterazione lenta |
| Controllo del codice e revisione | GitHub (branch, pull request, Actions) | Ogni modifica è un diff revisionabile; nulla raggiunge il branch principale senza revisione; la CI gira su ciascuna | Modifiche non revisionate che raggiungono la produzione; storia perduta; nessuna tracciabilità |
| Preview e deployment | Vercel (connesso a git) | Un preview isolato e funzionante di ogni pull request al proprio URL; deploy in produzione e rollback con un clic | Revisionare codice che non si può vedere funzionare; release rischiose |
| Framework web | Next.js (TypeScript) | I tipi come primo cancello automatico; struttura convenzionale, basata su file, che l’agente percorre bene | Intere classi di difetti che il type checker respinge; l’agente che si perde |
| Database | PostgreSQL (gestito) | Stato durevole e transazionale con migrazioni revisionate e versionate | Perdita di dati; deriva silenziosa dello schema; ambienti non riproducibili |
| Cancello di revisione umana | Una persona, alla pull request | Il giudizio che nessun cancello automatizza: è ciò che volevamo, ed è sicuro? | Codice sicuro di sé ma sbagliato che ha superato ogni controllo automatico |
4. L’agente: come si inserisce Claude Code
Claude Code è l’agente: uno strumento che legge la codebase, scrive e modifica file, esegue comandi, lancia i test e apre pull request, lavorando a partire da un’istruzione e correggendosi a fronte dei risultati che vede. Come lo si esegue conta più della capacità grezza del modello, e tre aspetti meritano l’attenzione di un professionista.
Il primo è il contesto. Un agente vale solo quanto ciò che sa della vostra codebase, e l’artefatto a più alta leva in assoluto è un file di convenzioni versionato, nel nostro caso un CLAUDE.md di progetto, che indica all’agente le regole della casa: come è organizzato il progetto, come eseguire il type checker e i test, cosa distribuire e come, cosa non toccare mai. L’agente lo legge a ogni esecuzione, cosicché una correzione messa per iscritto una volta smette di ripresentarsi. Attorno a esso sta una superficie più ampia: skill riutilizzabili per compiti ricorrenti, hook che girano sulle chiamate agli strumenti per imporre una regola in modo meccanico, e server MCP che danno all’agente un accesso tipizzato a sistemi esterni, GitHub tra questi, così che possa aprire e aggiornare pull request come azioni di prima classe anziché per screen-scraping. Il context engineering, decidere cosa l’agente debba sapere e saper fare, è il vero lavoro dell’adozione di uno di essi, ed è ordinaria igiene del software: mettere per iscritto le convenzioni, rendere eseguibili i controlli, mantenere piccola la superficie.
Il secondo è che l’agente gira dentro il ciclo anziché in isolamento. Ci si aspetta che esegua da sé il type checker e i test, legga ciò che segnalano e lo sistemi, prima che qualsiasi essere umano guardi, così che i cancelli automatici della catena siano già verdi nel momento in cui viene aperta una pull request. Per compiti più grandi può distribuire il lavoro a subagenti che portano ciascuno il proprio contesto e riferiscono, il che mantiene il thread principale concentrato e il contesto pulito. La disciplina è lasciare che il feedback rapido ed economico, i tipi e i test, avvenga dentro il ciclo stesso dell’agente, e riservare il feedback lento e costoso, l’essere umano, per la fine.
Il terzo è dove gira. Oltre al terminale, Claude Code gira come sessione cloud raggiungibile da un’app mobile, il che cambia la forma della giornata lavorativa. Una modifica può essere avviata da un telefono mentre si è in viaggio, lasciata girare nel cloud, e la sua pull request e il suo preview revisionati e approvati più tardi dallo stesso telefono. Siamo intenzionali in questo non perché il lavoro da mobile sia una novità, ma perché accorcia il ciclo: lo scarto tra l’accorgersi di qualcosa e l’avviare la modifica, e tra una modifica pronta e qualcuno che la approva, si riduce da ore a minuti, il che in un mondo vincolato dalla verifica è esattamente lo scarto che vale la pena chiudere.
5. La spina dorsale: GitHub
GitHub è la parte della catena che rende tutto il resto sicuro, ed è la meno appariscente. Custodisce la single source of truth, il repository, e impone la regola su cui poggia l’intero argomento: il branch principale, quello che spedisce, è protetto, e può essere raggiunto solo attraverso una pull request che un essere umano ha approvato e i cui controlli di stato obbligatori sono passati. L’agente non modifica mai direttamente il codice di produzione; propone, su un branch, e la proposta è un diff che un essere umano può leggere e una macchina può testare.
I controlli obbligatori sono il luogo in cui vivono i cancelli automatici. Su ogni pull request, GitHub Actions esegue la suite su cui insistiamo prima che qualunque cosa venga mergiata: il type checker, il linter, la suite di test e una build di produzione, ciascuno uno stato obbligatorio che blocca il pulsante di merge finché non è verde. Poiché sono imposti dalla piattaforma anziché dalla disciplina di qualcuno, non possono essere saltati in fretta, e poiché l’agente sa che gireranno, li soddisfa per primi. La pull request è l’unità di cambiamento: piccola, autocontenuta, revisionabile singolarmente e annullabile singolarmente, ed è ciò che mantiene la revisione poco costosa e la storia leggibile. E poiché ogni modifica è un commit con un autore e un messaggio, la storia è una traccia di audit e l’annullamento è totale: qualsiasi cosa l’agente abbia fatto può essere vista, attribuita e annullata. Un agente di codifica è un attore rapido, potente e fallibile, e GitHub è la struttura che rende sicuro lasciarne uno libero, garantendo che nulla di ciò che fa sia non revisionato, non testato o irreversibile.
6. Gli occhi: Vercel
Leggere un diff dice cosa è cambiato; non dice cosa fa la modifica. Vercel colma quel divario costruendo ogni pull request in un preview deployment: un’istanza completa, isolata e funzionante dell’applicazione con la modifica applicata, al proprio URL, creata automaticamente e aggiornata a ogni push. È il cancello che intercetta ciò che i tipi e i test non intercettano, il layout che si è rotto, il flusso che si è allungato di un passaggio, la cosa tecnicamente corretta e sbagliata nell’uso, ed è gran parte del motivo per cui la catena può muoversi veloce senza muoversi alla cieca. Un revisore, e l’agente, cliccano attraverso il risultato effettivo anziché immaginarlo dal codice.
Ciò che rende il preview affidabile è che è una build reale dell’intero stack, non un mock (Figura 2): lo stesso framework, lo stesso runtime, le proprie variabili d’ambiente e, se fatto bene, il proprio database isolato o derivato da branch, così che esercitarlo non possa toccare i dati di produzione. I deployment sono immutabili: ciascuno è una build distinta e indirizzabile, cosicché promuovere in produzione un preview revisionato è uno spostamento di puntatore anziché una ricostruzione, e una release difettosa è un rollback istantaneo al deployment immutabile precedente anziché un hotfix frenetico. Al merge sul branch principale lo stesso meccanismo che ha costruito il preview costruisce la produzione, così che la cosa revisionata è la cosa che viene spedita. Nel modello di questa catena, i preview deployment sono un cancello di verifica economico e automatico con un alto tasso di intercettazione per una classe di difetti che nessun altro cancello vede.
7. Senza soluzione di continuità grazie a git: perché i tre si incastrano
La ragione per cui Claude Code, GitHub e Vercel appaiono meno come tre strumenti e più come un unico sistema è che condividono un’unica interfaccia, e quell’interfaccia è git. L’output naturale di Claude Code non è un deployment; è un branch e una pull request. Il compito di GitHub è conservare quei commit, eseguire i controlli e ospitare la revisione. Vercel osserva il repository e trasforma ogni branch in un preview e il branch principale in produzione. Nessuno di loro ha dovuto essere istruito sugli altri: l’agente non impara mai un’API di deployment, apre una pull request; Vercel non impara mai dell’agente, osserva il repo. La giuntura tra loro è il protocollo git che tutti e tre già parlano, ed è per questo che aggiungere un agente alla catena non ha cambiato nulla di come funzionava il deployment, e perché l’intero percorso da un prompt alla produzione non ha passaggi di consegne al suo interno.
La conseguenza è che il deployment smette di essere un passaggio che qualcuno compie e diventa una conseguenza dell’azione git che avrebbe comunque compiuto. Un push è una build. Una pull request è un ambiente di preview, creato e smantellato da sé. Un merge sul branch principale è un deploy in produzione. Un revert è un rollback. Nessuno esegue una release; fanno il merge, e la release accade. Non c’è un build server da sorvegliare, nessuno script di deploy che l’agente possa sbagliare, nessuno strumento di promozione separato, nessuna finestra in cui qualcuno ha scritto il codice ma non lo ha ancora spedito. Per un team vincolato dalla verifica questo è esattamente il punto giusto in cui rimuovere l’attrito: l’unico atto umano deliberato rimasto nel percorso è la revisione, che è l’unico atto che dovrebbe essere deliberato, e tutto il meccanico attorno a esso è gestito dagli strumenti che osservano git.
Questo è anche il motivo per cui l’assenza di soluzione di continuità è sicura anziché avventata, e le due proprietà derivano dallo stesso fatto. Poiché il deployment viaggia su git, eredita le garanzie di git: ogni deploy di produzione è legato a uno specifico commit revisionato, con un autore e un messaggio; ogni preview è legato a un branch; e poiché i deployment sono immutabili, fare il rollback è semplicemente puntare la produzione alla build di un commit precedente. Lo stesso cablaggio che consente a una modifica di fluire da un prompt digitato sul telefono a un sito live senza che nessuno tocchi una console di deploy garantisce anche che nulla raggiunga quel sito live se non attraverso un commit revisionato, attribuibile e annullabile. L’integrazione è un connubio non perché i fornitori l’abbiano coordinata, ma perché tutti e tre sono stati costruiti per trattare git come fonte di verità, e quando l’agente si è unito a quella convenzione, la pipeline di cui aveva bisogno era già lì.
8. Il terreno: Next.js
L’agente deve orientarsi in una codebase, e il framework della codebase è il terreno. Next.js è una scelta forte per due ragioni che riconducono entrambe alla verifica. La prima è che è TypeScript, e i tipi sono il primo e meno costoso cancello. Eseguito in modalità strict, il type checker respinge un’ampia classe di errori, una forma sbagliata, un campo mancante, un valore che potrebbe essere null, nel momento in cui l’agente lo scrive, che è esattamente quando una correzione è meno costosa, prima che il codice giri e molto prima che un essere umano guardi. Spingiamo la stessa idea ai bordi del programma, validando l’input esterno, i corpi delle richieste, le variabili d’ambiente, le righe del database, a fronte di uno schema, così che i dati non tipizzati provenienti dall’esterno diventino tipizzati e controllati al confine anziché dati per buoni. I tipi qui non sono burocrazia; sono il cancello che trasforma l’errore più comune dell’agente, una forma plausibile ma sottilmente sbagliata, in uno scarabocchio rosso che corregge da sé.
La seconda ragione è che Next.js è convenzionale, e il suo modello, per quanto ricco, è abbastanza battuto da far sì che l’agente lo scriva con scioltezza. Vale la pena essere concreti su quel modello, perché è dove vive gran parte dell’ingegneria. L’App Router esegue il rendering sul server per impostazione predefinita: i Server Components girano sul server e non spediscono mai il proprio codice al browser, mantenendo lato server l’accesso ai dati e i segreti, mentre i Client Components, contrassegnati esplicitamente, portano l’interattività. Le mutazioni passano attraverso le Server Actions, funzioni server che un form o un pulsante possono chiamare direttamente, e i Route Handlers forniscono la superficie API. Ogni route sceglie come eseguire il rendering, statico al momento della build, rigenerato in modo incrementale secondo una pianificazione, o dinamicamente a ogni richiesta, e dove viene eseguita, il runtime Edge leggero vicino all’utente o il più completo runtime Node.js, con il middleware che gira prima della richiesta per gestire cose come l’autenticazione e il locale. Si tratta di molte leve, ma sono leve pubbliche, documentate e stabili che l’agente ha visto usate correttamente su larga scala, così che afferra quella giusta, e il framework è abbastanza potente da costruire un prodotto reale pur restando il terreno su cui l’agente è più capace, che, per l’argomento della Sezione 3, è la combinazione che conta.
9. Lo stato: Postgres
Tutto quanto precede riguarda il codice, che è sicuro modificare perché è versionato e reversibile. I dati non lo sono: una colonna eliminata o una migrazione difettosa può distruggere qualcosa che nessun commit può ripristinare. Postgres è lo stato durevole e transazionale in fondo alla catena, e la disciplina che lo circonda è deliberatamente più severa di quella attorno al codice. PostgreSQL si guadagna il proprio posto nello stesso modo del resto della catena: è la scelta convenzionale, collaudata e magnificamente documentata, cosicché l’agente scrive SQL corretto e migrazioni corrette su di esso, e un’istanza gestita rimuove la fatica operativa senza cambiare il modello.
La cura va nel cambiamento. Le modifiche allo schema sono migrazioni: file ordinati e versionati, inseriti nel repository e revisionati come qualsiasi altra modifica, eseguiti sul preview prima della produzione, e scritti per essere reversibili. Un database in produzione non può essere modificato come uno nuovo di zecca, perciò una modifica rischiosa viene realizzata come una sequenza di modifiche sicure, il pattern expand and contract (Ambler & Sadalage, 2006): aggiungere la nuova colonna o tabella e iniziare a scriverci, fare il backfill, spostare le letture, e solo allora, in un deployment successivo, rimuovere la vecchia forma, così che a ogni passaggio intermedio il codice in esecuzione e lo schema siano compatibili e il passaggio sia reversibile. Postgres aiuta rendendo transazionali la maggior parte delle modifiche allo schema, cosicché una migrazione fallita fa il rollback in modo pulito anziché lasciare il database a metà. Due aspetti operativi contano in un contesto serverless, dove molte istanze di funzione di breve durata vogliono ciascuna una connessione: un connection pooler non è opzionale, perché un database ha un limite rigido di connessioni che una flotta di worker serverless altrimenti esaurirà; e la row-level security consente al database stesso di imporre chi può vedere quali righe, una rete di sicurezza che non dipende dal fatto che l’applicazione formuli correttamente ogni query. La regola che manteniamo è semplice e vale la pena enunciarla: l’agente può proporre una migrazione, ma una migrazione è l’unico tipo di modifica che un essere umano legge sempre con piena attenzione, perché è l’unico tipo che la catena non può annullare del tutto.
10. Il cancello umano e come fallisce
Ogni cancello automatico di questa catena esiste per rendere economico il cancello umano, non per eliminarlo. Il revisore alla pull request fa l’unica cosa che nessun cancello automatizza: giudicare se la modifica sia ciò che l’azienda voleva davvero e se sia sicura da esporre, domande che i tipi, i test e i preview informano ma non rispondono. Lo scopo stesso della catena è consegnare a quel revisore una modifica piccola, funzionante e pre-controllata, così che il giudizio sia rapido e ben fondato. Ma il cancello ha modalità di fallimento caratteristiche, e nominarle fa parte dell’usare bene la catena.
Il primo è il timbro automatico. Quando l’agente ha di solito ragione, il revisore impara ad approvare in fretta, e la revisione degrada in una formalità che non intercetta nulla. La difesa è mantenere piccole le modifiche, così che leggerle come si deve resti poco costoso, e trattare il preview come obbligatorio, non opzionale: una revisione che non ha cliccato attraverso la modifica in funzione non è una revisione. Il secondo è l’eccesso di fiducia, la convinzione che, poiché il codice ha superato il type checker e i test, debba essere corretto; quei cancelli intercettano forme e comportamenti ma non l’intento, e l’essere umano è l’unico cancello sull’intento. Il terzo è la fatica da scala: un agente può aprire più pull request di quante un team possa revisionare seriamente, e un arretrato di modifiche revisionate a metà è il regime vincolato dalla verifica che si riafferma. La risposta non è revisionare più in fretta ma generare in modo più deliberato, lasciare che l’agente produca solo ciò che il team può effettivamente verificare, perché una modifica non verificata è un passivo qualunque sia il suo volume.
11. Costi e compromessi
La catena è un insieme di scelte, e l’onestà richiede di enunciare cosa costano. La più evidente è l’accoppiamento: Next.js e Vercel provengono dalla stessa azienda, e costruire su di essi compra un percorso fluido e integrato al prezzo di un certo grado di lock-in, sia verso un framework che si muove in fretta e talvolta rompe la compatibilità tra versioni major, sia verso una piattaforma di hosting di cui si adottano i prezzi e le primitive. Giudichiamo lo scambio valido per la velocità e la qualità del ciclo di preview, ma è una dipendenza reale, e un team dovrebbe mantenere portabili la propria logica di dominio e i propri dati, così che il framework e l’host restino infrastruttura sostituibile anziché il prodotto. Il secondo costo è la disciplina che il cancello richiede: la catena è sicura solo quanto la revisione in cui culmina, e un team che lascia decadere il cancello umano a timbro automatico ha un modo veloce per spedire errori sicuri di sé, che è peggio di un modo lento per spedirne di ponderati. Il terzo è l’accesso dell’agente: uno strumento che può modificare il repository e innescare deployment è un attore potente, e va delimitato come tale, con la protezione dei branch, con credenziali a privilegio minimo, con i segreti tenuti fuori dal repository e fuori dalla portata dell’agente, e con le modifiche ai permessi e all’infrastruttura revisionate con particolare cura. Il quarto è l’irreversibilità dei dati, trattata sopra: l’unico punto in cui la rete di sicurezza della catena ha un buco, e il luogo in cui spendere la massima attenzione umana. Nessuno di questi è una ragione per non adottare la catena; ciascuno è una ragione per adottarla deliberatamente.
12. Come ci facciamo funzionare la piattaforma Nashua 360
La catena di questo articolo non è una proposta che abbiamo teorizzato; è quella su cui costruiamo e operiamo il nostro prodotto. La Nashua 360 Enterprise Platform è un’applicazione Next.js, distribuita su Vercel, sostenuta da Postgres, con il suo sorgente su GitHub, ed è sviluppata con Claude Code come agente, anche dall’app mobile quando una modifica è meglio avviata o approvata lontano da una scrivania. Un file di convenzioni versionato indica all’agente le regole della casa; ogni modifica alla piattaforma è un branch e una pull request; ogni pull request riceve il proprio type check, la propria esecuzione di continuous integration e il proprio preview deployment su una copia isolata dello stack; nulla raggiunge il branch di produzione senza che un essere umano legga il diff e clicchi attraverso il preview; e le migrazioni sono le modifiche che leggiamo con maggiore attenzione. Non abbiamo assemblato questa catena per essere alla moda. L’abbiamo assemblata perché, una volta accettato che un agente aveva reso economica la generazione e la verifica il vincolo, ogni anello è seguito dalla domanda di come verificare in modo rapido e sicuro, e perché lo stesso ragionamento che la rende giusta per noi, strumenti convenzionali che l’agente gestisce bene, avvolti in cicli e cancelli che intercettano i suoi errori, la rende giusta per la maggior parte dei team che oggi costruiscono software web. Che consenta anche di far progredire un prodotto serio da un telefono su un treno non è la ragione per cui l’abbiamo scelta, ma è un buon segno di quanto sia cambiata la forma del lavoro.
13. Obiezioni e risposte
Questa è solo continuous delivery con un agente innestato sopra. In larga parte, deliberatamente. Le pratiche su cui poggia la catena, il controllo di versione, le piccole modifiche revisionate, la continuous integration, il deployment automatizzato con preview e rollback, sono la disciplina consolidata della moderna software delivery (Humble & Farley, 2010; Forsgren et al., 2018), ed è questo il punto: l’agente non sostituisce quella disciplina, ne alza il premio, perché è la disciplina che fornisce la verifica che la velocità dell’agente ora richiede. Il contributo non è una pratica nuova ma l’argomento del perché le vecchie pratiche contino di più, non di meno, una volta che la generazione è economica.
Un modello migliore renderà superflui gli strumenti. Non lo farà, perché gli strumenti affrontano la parte che un modello migliore non tocca. Un agente più capace genera più in fretta e, in un mondo vincolato dalla verifica, generare più in fretta non alza ciò che viene effettivamente spedito; solo verificare più in fretta lo fa. Il modello migliore produce anche più codice, più in fretta, perché un essere umano lo controlli, il che rende i cancelli più necessari, non meno. La catena è una scommessa sulla verifica, e quella scommessa migliora, non peggiora, man mano che la generazione migliora.
Siete vincolati allo stack di un unico fornitore. In parte, e lo abbiamo detto. L’accoppiamento di Next.js e Vercel è un costo reale accettato per un beneficio reale, il ciclo di preview integrato che è centrale all’intero argomento. La mitigazione è mantenere portabile la logica essenziale, il codice di dominio e il database, e trattare il framework e l’host come infrastruttura sostituibile. Un team con una diversa propensione al rischio può mantenere la forma della catena, agente, controllo di versione, preview isolato, framework tipizzato, database revisionato, su altri componenti.
14. Limiti
Questo è un consiglio rivolto ai professionisti, e i suoi limiti vanno enunciati. È una raccomandazione ragionata e fondata sul nostro stesso uso, non un confronto controllato; non abbiamo misurato la catena a fronte di alternative. Gli strumenti specifici sono attuali alla fine del 2026, e questo è un campo in rapido movimento: l’argomento, che la verifica è il vincolo e che la catena va letta come cicli e cancelli, è pensato per sopravvivere a qualsiasi strumento particolare, ma gli strumenti particolari cambieranno, e un lettore dovrebbe conservare l’argomento e riesaminare le parti. La raccomandazione è circoscritta al tipo di software che costruiamo, applicazioni web con un database, e si trasferisce meno direttamente a domini con vincoli diversi, come i sistemi in cui il costo di un cancello di verifica è di per sé proibitivo, o in cui nessun agente ha visto abbastanza dello stack da potervisi fidare. E la sicurezza della catena poggia su un cancello umano che la catena rende economico ma non può rendere automatico; un team che non voglia tenere onesto quel cancello deve aspettarsi la velocità senza la sicurezza.
15. Conclusione
Un agente di codifica rende rapida la scrittura del software, e così facendo porta allo scoperto la parte difficile. La generazione, la parte che un tempo dominava la giornata, diventa economica; la verifica, decidere cosa costruire ed essere certi che il risultato sia giusto, no, e diventa il vincolo. La lezione per gli strumenti è che il valore di un setup assistito dall’IA non sta nell’agente ma nella catena attorno a esso che consente a un team di verificare alla velocità con cui l’agente genera e intercetta i suoi errori prima che lo facciano gli utenti. Costruiamo e facciamo funzionare la piattaforma Nashua 360 su una catena di questo tipo: Claude Code per scrivere, in un ciclo con i controlli e raggiungibile da un telefono; GitHub per rendere ogni modifica un diff revisionato e reversibile dietro un branch protetto; Vercel per dare a ogni modifica il proprio preview funzionante e a ogni release un rollback istantaneo; Next.js come terreno tipizzato e convenzionale i cui tipi sono il primo cancello; e Postgres come stato durevole modificato attraverso migrazioni revisionate e reversibili. Ciascun anello chiude un ciclo o aggiunge un cancello, i cancelli sono indipendenti così che nessuno di essi debba essere perfetto, e l’insieme è scelto secondo un criterio particolare a questo momento: che per un agente, lo strumento convenzionale è quello capace. Scrivete veloce, verificate più veloce, e non lasciate che nulla raggiunga la produzione senza che una persona l’abbia visto funzionare. Questo è tutto, ed è abbastanza.
Appendice A. Una checklist di adozione
Le pratiche che seguono sono ciò che rende la catena sicura anziché meramente veloce. Nessuna è inedita; la disciplina è il valore.
Tabella 2. Una checklist di adozione. Ogni pratica tiene onesto un cancello o breve un ciclo; la colonna di destra è il fallimento che previene.
| Pratica | Cosa previene |
|---|---|
| Proteggere il branch principale; fare il merge solo tramite pull request revisionata con controlli obbligatori | Modifiche non revisionate o non testate che raggiungono la produzione |
| Mantenere un file di convenzioni versionato per l’agente | Ripetere le stesse correzioni; deriva del contesto |
| Mantenere piccole le modifiche | La revisione che degrada in timbro automatico |
| Far eseguire all’agente i tipi e i test prima di consegnare | Un essere umano che fa la verifica della macchina |
| Trattare il preview come obbligatorio nella revisione | Approvare codice che nessuno ha visto funzionare |
| Dare ai preview dati isolati | Una revisione che tocca i dati di produzione |
| Leggere ogni migrazione con piena attenzione; prima expand poi contract | L’unica modifica che la catena non può annullare |
| Tenere i segreti fuori dal repository e dalla portata dell’agente; privilegio minimo | Un attore potente con credenziali di cui non ha bisogno |
| Generare solo ciò che si può verificare | Un arretrato di modifiche non verificate e passibili di rischio |
Bibliografia
Ambler, S. W., & Sadalage, P. J. (2006). Refactoring databases: Evolutionary database design. Addison-Wesley. ISBN 978-0-321-29353-5.
Bacchelli, A., & Bird, C. (2013). Expectations, outcomes, and challenges of modern code review. In Proceedings of the 35th International Conference on Software Engineering (ICSE) (pp. 712–721). IEEE. https://doi.org/10.1109/ICSE.2013.6606617
Beck, K. (2000). Extreme programming explained: Embrace change. Addison-Wesley. ISBN 978-0-201-61641-5.
Brooks, F. P. (1987). No silver bullet: Essence and accidents of software engineering. Computer, 20(4), 10–19. https://doi.org/10.1109/MC.1987.1663532
Chen, M., Tworek, J., Jun, H., et al. (2021). Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374. https://arxiv.org/abs/2107.03374
Anthropic (2026). Claude Code documentation. https://code.claude.com/docs
Forsgren, N., Humble, J., & Kim, G. (2018). Accelerate: The science of lean software and DevOps: Building and scaling high performing technology organizations. IT Revolution Press. ISBN 978-1-942788-33-1.
Fowler, M. (2006). Continuous integration. martinfowler.com. https://martinfowler.com/articles/continuousIntegration.html
GitHub (2026). GitHub documentation. https://docs.github.com
Humble, J., & Farley, D. (2010). Continuous delivery: Reliable software releases through build, test, and deployment automation. Addison-Wesley. ISBN 978-0-321-60191-9.
Vercel (2026). Next.js documentation. https://nextjs.org/docs
Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv preprint arXiv:2302.06590. https://arxiv.org/abs/2302.06590
PostgreSQL Global Development Group (2026). PostgreSQL documentation. https://www.postgresql.org/docs/
Reason, J. (2000). Human error: Models and management. BMJ, 320(7237), 768–770. https://doi.org/10.1136/bmj.320.7237.768
Sadowski, C., Söderberg, E., Church, L., Sipko, M., & Bacchelli, A. (2018). Modern code review: A case study at Google. In Proceedings of the 40th International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP) (pp. 181–190). ACM. https://doi.org/10.1145/3183519.3183525
Vercel (2026). Vercel documentation. https://vercel.com/docs